세일즈포스가 드림포스에서 첫 자체 추론 모델 ‘Koa’를 공개했습니다. 엔비디아의 오픈웨이트 Nemotron을 기반으로 영업·마케팅·고객지원 업무에 맞춰 후처리 학습한 모델입니다.
학습에 고객 실데이터를 쓰지 않고 합성 데이터만 사용했습니다. 데이터 유출 리스크를 구조적으로 차단하면서 같은 일을 더 적은 토큰으로 처리하는 것이 핵심 설계 목표입니다.
엔터프라이즈 AI 플랫폼 Writer는 오픈웨이트 모델을 후처리한 Palmyra X6와 재설계한 오케스트레이션 계층으로 에이전트 운영비를 평균 52% 낮췄다고 밝혔습니다.
골드만삭스는 2026~2030년 토큰 소비량이 24배 늘어 월 120경(quadrillion) 토큰에 이를 것으로 전망합니다. 단가 하락이 청구서 하락을 뜻하지 않는다는 점이 핵심입니다.
지난주 샌프란시스코에서 열린 드림포스에서 세일즈포스가 내놓은 가장 무거운 발표는 새 기능이 아니었습니다. 자사 첫 추론 모델 ‘Koa’였습니다. 그동안 세일즈포스는 여러 개의 작은 업무 특화 모델을 만들어 왔지만, 여러 단계를 스스로 계획하고 판단해야 하는 ‘추론’ 영역만큼은 클로드나 챗GPT 같은 프론티어 모델에 넘겨왔습니다. 이번에 그 마지막 조각을 직접 가져온 것입니다. 같은 시기에 엔터프라이즈 AI 기업 Writer도 자체 모델로 에이전트 비용을 절반으로 줄였다고 발표했습니다. 두 사건은 따로 일어났지만 같은 곳을 가리킵니다. SaaS 기업들이 AI 원가 구조를 남의 손에 맡기지 않기로 결심하기 시작했다는 신호입니다.
세일즈포스는 왜 직접 모델을 만들었나
“출발점이 될 기반 모델이 없었다”
제이예시 고빈다라잔 세일즈포스 AI 총괄은 테크크런치에 “자체 엔터프라이즈급 모델을 만들고 싶었지만 출발점으로 삼을 사전학습 기반 모델이 없었다”고 말했습니다. 그가 꼽은 조건은 세 가지였습니다. 미국산 오픈 모델일 것, 성능이 최고 수준일 것, 그리고 학습 데이터의 출처가 명확할 것. 엔비디아의 Nemotron이 나오기 전까지는 이 세 조건을 모두 만족하는 선택지가 없었다는 설명입니다.
세 번째 조건은 특히 한국 기업에도 그대로 적용됩니다. 값이 싸다는 이유로 출처가 불투명한 오픈 모델을 제품에 얹으면, 나중에 고객사 보안 심사나 공공 조달 단계에서 설명할 수 없는 항목이 생깁니다. 모델 선택은 성능 비교표가 아니라 ‘나중에 설명할 수 있는가’의 문제로 바뀌고 있습니다.
고객 데이터를 한 줄도 쓰지 않은 학습
Koa의 후처리 학습에는 세일즈포스 고객의 실제 데이터가 전혀 사용되지 않았습니다. 대신 가상의 고객센터 환경을 만들어 합성 데이터를 생성했습니다. 화가 난 고객이 전화를 거는 상황, 계약을 마무리하려는 영업 담당자의 대화까지 시뮬레이션해 학습 데이터로 썼다는 것입니다. 모델이 고객 데이터를 학습하지 않았으니 다른 고객에게 유출할 경로 자체가 없다는 논리입니다.
AI Biz Insider 분석 — 합성 데이터 학습은 성능을 위한 선택이 아니라 영업을 위한 선택입니다. 금융·의료·공공처럼 데이터 반출이 까다로운 고객에게 “귀사 데이터는 학습에 쓰이지 않습니다”를 계약서 문장으로 제시할 수 있느냐가 수주를 가릅니다. 기술 사양이 아니라 계약 조건으로 번역되는 순간 이 결정의 가치가 보입니다.
진짜 문제는 성능이 아니라 청구서였다
챗봇과 에이전트의 결정적 차이
챗봇은 질문 하나에 답변 하나를 만듭니다. 에이전트는 다릅니다. 요청 하나가 계획 수립, 자료 검색, 도구 호출, 검증, 재시도로 쪼개지고 그 모든 반복이 토큰으로 과금됩니다. 사용자는 답변 하나를 보지만 청구서에는 그 전체 루프가 찍힙니다. 도입 초기에 비용 추정이 크게 빗나가는 이유가 여기 있습니다.
골드만삭스는 2026년부터 2030년까지 토큰 소비량이 24배 늘어 월 120경 토큰 규모에 이를 것으로 내다봤습니다. 사람이 질문을 더 많이 해서가 아니라, 상시 가동되는 기업용 에이전트가 늘기 때문입니다. 같은 분석은 냉정한 계산도 덧붙였습니다. 작업당 토큰 사용량이 20배로 늘고 단가가 75% 떨어져도 총비용은 5배로 늘어납니다.
Writer의 52%, 그리고 더 중요한 41%
Writer는 새 모델 Palmyra X6와 함께 에이전트 운영비 평균 52% 절감, 속도 48% 개선을 발표했습니다. 그런데 이 회사가 같이 공개한 연구에서 더 눈여겨볼 숫자는 따로 있습니다. 모델을 바꾸지 않고 ‘하네스’라 부르는 오케스트레이션 계층만 재설계했을 때 비용이 41% 줄었고, 이 효과는 앤트로픽과 오픈AI 모델을 포함해 테스트한 모든 모델에서 동일하게 나타났습니다.
즉 절감의 상당 부분은 ‘어떤 모델을 쓰느냐’가 아니라 ‘그 모델을 어떻게 태우느냐’에서 나왔다는 뜻입니다. 맥락을 어떻게 잘라 넣는지, 작업을 묶어서 보내는지, 하위 에이전트에 언제 넘기는지가 모델 교체보다 큰 변수였습니다. 모델 벤치마크 점수를 비교하느라 몇 주를 쓴 조직이라면 우선순위를 다시 볼 필요가 있습니다.
AI Biz Insider 분석 — 토큰 단가표로 견적을 내면 반드시 틀립니다. 실무에서 맞는 지표는 ‘성공한 작업 1건당 비용’입니다. 재시도, 도구 호출, 사람에게 넘어간 에스컬레이션까지 모두 포함해 계산해야 합니다. 이 숫자를 모르는 상태에서 전사 확대를 결정하면, 확대 규모만큼 손실도 정직하게 커집니다.
우리 회사는 지금 무엇을 점검해야 하나
비용 구조부터 다시 그리기
첫째, 워크플로별로 토큰 사용량을 분리해 보십시오. 어떤 업무가 비용을 끌어올리는지 모르면 어떤 협상도 시작할 수 없습니다. 둘째, 전 업무를 최고 성능 모델에 태우고 있다면 지금 멈추십시오. 요약, 분류, 추출처럼 반복적이고 판단 여지가 적은 작업은 작은 모델로 충분합니다. 셋째, 모델 교체 전에 맥락 관리와 호출 구조부터 손보십시오. 같은 모델로도 절반을 줄일 수 있습니다.
오픈 모델이 항상 싸지는 않습니다
Nous Research가 19개 모델을 비교한 연구에 따르면, 오픈웨이트 모델은 같은 문제를 푸는 데 폐쇄형 모델보다 1.5~4배 많은 토큰을 씁니다. 단순 지식 질문에서는 최대 10배까지 벌어졌습니다. 토큰 단가가 낮아도 사용량이 많으면 질의당 비용은 오히려 비싸질 수 있다는 의미입니다. “오픈 모델로 바꾸면 싸진다”는 가정은 반드시 자사 데이터로 검증한 뒤에 받아들여야 합니다.
통제권이라는 또 하나의 변수
Writer의 제품 총괄은 자체 모델을 만든 이유를 비용이 아니라 통제권으로 설명했습니다. 외부 랩이 모델을 갑자기 단종해도, 어떤 데이터로 학습했는지 답을 요구받아도 스스로 통제할 수 없다는 것입니다. 실제로 모델 버전 하나가 사라지면 그 위에 얹은 프롬프트와 평가 기준이 함께 흔들립니다. 중소 조직이 모델을 직접 만들 수는 없어도, 최소한 특정 모델에 종속되지 않도록 추상화 계층을 두고 대체 경로를 확보해 두는 일은 지금 당장 가능합니다.
AI Biz Insider 분석 — 이번 흐름의 결론은 “모두 자체 모델을 만들라”가 아닙니다. 가치가 사전학습에서 ‘마지막 1마일’, 즉 후처리와 오케스트레이션과 거버넌스로 이동하고 있다는 것입니다. 경쟁력은 가장 똑똑한 모델을 고르는 능력이 아니라, 고른 모델로 원가를 통제하는 능력에서 나옵니다.
6월에 1차 모집이 끝났을 때 “다음은 언제냐”는 질문이 유독 많았던 상품입니다. 금융위원회와 서민금융진흥원이 9월 16일, 그 답을 내놨습니다. 청년미래적금 2차 가입 신청이 10월 7일부터 16일까지 열립니다. 열흘짜리 창구이고, 이번에는 청년도약계좌에서 갈아탈 수 있는 길까지 함께 열렸습니다.
먼저 달력에 찍어야 할 날짜 네 개
이 상품은 신청하고 끝이 아닙니다. 신청 – 심사 – 계좌 개설까지 세 단계가 각각 다른 기간에 진행되고, 마지막 단계를 놓치면 심사를 통과해도 계좌가 만들어지지 않습니다.
단계
기간
가입 신청(출생연도 끝자리 홀수)
10월 7일
가입 신청(출생연도 끝자리 짝수)
10월 8일
가입 신청(출생연도 무관, 전체)
10월 12일~16일
가입 심사(결과는 개별 안내)
10월 19일~11월 13일
취급기관에서 계좌 개설
11월 16일~27일
정책 분석 — 홀짝제는 10월 7일과 8일에만 적용되고, 12일부터는 누구나 신청할 수 있습니다. 그래서 “내 날짜를 놓쳤다”며 포기하는 것이 가장 흔한 실수입니다. 반대로 홀짝제 이틀은 접속자가 분산돼 화면이 덜 밀리는 구간이기도 합니다. 본인 출생연도 끝자리에 해당하는 날에 먼저 시도하고, 서류나 소득 확인이 막히면 12일 이후 다시 붙는 2단 전략이 안전합니다. 심사 결과는 일괄 공지가 아니라 개별 안내이므로, 신청 때 등록한 연락처와 알림 수신 설정을 그대로 두는 것도 중요합니다.
나는 대상일까, 30초면 끝납니다
30초 자격 체크
1991년 11월 17일생에서 2007년 11월 27일생 사이인가(병역 이행자는 최대 6년 제외)
전년도 총급여가 7500만 원 이하인가(종합소득은 6300만 원 이하)
소상공인이라면 전년도 연매출이 3억 원 이하인가
가구 기준 중위소득이 200% 이하인가
네 줄 모두 예라면 가입 대상입니다. 소득과 매출은 모두 전년도 기준으로 판단하고, 소득이 없거나 소득금액 증명이 불가능한 경우, 그리고 전년도 국세청 신고 매출이 없는 소상공인은 가입할 수 없습니다.
연매출이 3억 원을 넘는 소상공인이라도 종합소득이 6300만 원 이하라면 일반소득자 자격으로 가입할 수 있습니다. 사업장을 여러 개 보유했다면 매출은 합산액 기준입니다.
기여금 6%와 12%가 갈리는 지점
가입만 되면 끝이 아닙니다. 같은 금액을 넣어도 일반형이냐 우대형이냐에 따라 받는 돈이 두 배 차이 납니다.
구분
기준과 매칭 비율
일반형 · 일반소득자
총급여 6000만 원(종합소득 4800만 원) 이하 + 중위소득 200% 이하 → 6%
일반형 · 소상공인
연매출 3억 원 이하 + 중위소득 200% 이하 → 6%
우대형 · 소상공인
연매출 1억 원 이하 + 중위소득 150% 이하 → 12%
우대형 · 중소기업 신규취업자
총급여 6000만 원 이하 + 중위소득 200% 이하, 2025년 최초 취업 후 현재 중소기업 재직 → 12%
우대형 · 중소기업 재직자
총급여 3600만 원(종합소득 2600만 원) 이하 + 중위소득 150% 이하 → 12%
기여금 없음, 비과세만
총급여 6000만 원 초과~7500만 원 이하 + 중위소득 200% 이하
정책 분석 — 놓치기 쉬운 두 가지가 있습니다. 첫째, 맞벌이 2인 가구는 중위소득 기준이 완화됩니다. 200% 기준은 250%로, 150% 기준은 200%로 올라가므로 “맞벌이라 소득이 합산돼서 안 되겠지”라고 지레 포기할 필요가 없습니다. 둘째, 중소기업 우대형은 지금 당장 조건을 못 채워도 길이 있습니다. 만기 한 달 전 시점까지 총 29개월 이상 중소기업에 재직하면 3년 전체 기간에 대해 우대형 혜택을 인정받습니다. 중간에 이직하더라도 중소기업 재직 기간을 29개월 이상으로 관리하는 것이 실질 수령액을 좌우합니다.
월 50만 원을 3년 넣으면 실제로 얼마가 남나
정부가 제시한 숫자는 우대형 기준 2255만 원입니다. 금리는 최고 연 7~8% 수준이고 이자소득세는 비과세입니다. 이 구조를 일반 적금 수익률로 환산하면 연 최고 19.4%라는 것이 금융위원회의 설명입니다.
숫자를 뜯어보면 이렇습니다. 월 50만 원씩 36개월이면 본인 납입금은 1800만 원입니다. 여기에 유형별 기여금과 비과세 이자가 붙습니다.
항목(월 50만 원 · 36개월 기준)
금액
본인 납입 원금
1800만 원
정부 기여금 · 일반형 6%(월 3만 원)
108만 원
정부 기여금 · 우대형 12%(월 6만 원)
216만 원
우대형 만기 수령액(정부 제시)
2255만 원
원금 1800만 원과 우대형 기여금 216만 원을 빼면 나머지 약 239만 원이 비과세 이자에 해당합니다. 일반형과 우대형의 기여금 차이만 따져도 108만 원입니다. 같은 돈을 넣고도 유형 하나로 이만큼이 갈립니다.
정책 분석 — 월 50만 원이 부담스러워 포기하는 경우가 많은데, 이 상품의 최소 납입액은 월 1000원이고 한도 안에서 자유롭게 넣는 자유적립식입니다. 기여금은 납입액에 비례하므로 적게 넣으면 적게 받을 뿐, 계좌 자체를 못 여는 것은 아닙니다. 중요한 것은 지금 만들어 두느냐입니다. 나이 요건은 가입 시점에만 따지고, 가입 기간 중 34세를 넘겨도 계좌는 그대로 유지됩니다. 즉 34세에 가까운 청년일수록 이번 열흘이 사실상 마지막 기회일 수 있습니다.
청년도약계좌에서 갈아타기, 순서를 틀리면 손해입니다
이번 2차 모집의 가장 큰 변화입니다. 기존 청년도약계좌 가입자에게 청년미래적금으로 옮겨탈 기회가 추가로 제공됩니다. 다만 절차의 순서가 정해져 있습니다.
갈아타기 3단계
청년미래적금 가입 신청과 심사를 마치고 가입 가능 안내를 받는다
청년미래적금 계좌를 먼저 개설한다
그 다음 청년미래적금 가입 목적의 청년도약계좌 특별중도해지를 신청한다
정책 분석 — 순서를 뒤집어 청년도약계좌부터 해지하면 안 됩니다. 청년미래적금 심사에서 탈락할 경우 두 계좌를 모두 잃는 상황이 되기 때문입니다. 정부가 “신청·심사 완료 후 계좌 개설, 그 다음 특별중도해지”라고 단계를 못 박아 안내한 이유가 여기에 있습니다. 세부 절차는 서민금융진흥원이 카카오톡 알림톡 등으로 따로 안내할 예정이므로, 알림톡 수신을 차단해 둔 상태라면 지금 풀어 두는 편이 낫습니다. 심사 방식도 개선됐습니다. 신청 단계에서 중소기업 재직 여부를 본인이 직접 선택하고 이를 KoDATA 정보와 대조하는 상호 검증 체계가 도입되며, 최종 확정 전에 가심사 결과를 미리 알려 주고 소명할 기회를 줍니다. 1차 때 “왜 떨어졌는지 모르겠다”던 문제를 손본 셈입니다.
왜 지금 들어가야 유리한가
국회에 제출된 2027년 정부 예산안에는 청년미래적금을 손보는 내용이 담겨 있습니다. 가입 대상을 모든 청년으로 확대하고, 우대형 정부 기여금 매칭 비율을 12%에서 15%로 올리는 것이 골자입니다. 지방 중소기업에 근무하는 경우에는 25%까지 적용됩니다.
핵심은 이 개편이 확정되면 기존 가입자에게도 소급 지급한다는 점입니다. 보통은 제도가 좋아지길 기다렸다가 나중에 들어가는 것이 유리하지만, 이번에는 정반대입니다. 먼저 들어가도 상향분을 받습니다.
기다렸을 때 잃는 것
월 50만 원 납입을 가정하면 우대형 12%일 때 기여금은 216만 원, 15%로 오르면 270만 원입니다. 지방 중소기업 근무로 25%가 적용되면 450만 원까지 늘어납니다. 지금 가입해 두면 이 차액이 나중에 따라옵니다.
반면 이번 열흘을 흘려보내면 다음 모집 시점은 현재 공지되지 않았습니다. 1차 모집이 6월이었고 2차가 10월이니 대략 넉 달 간격이지만, 이는 확정된 주기가 아닙니다. 그 사이 만 34세를 넘기면 자격 자체가 사라집니다.
정책 분석 — 이 상품이 설계된 배경을 보면 방향이 읽힙니다. 청년희망적금에서 청년도약계좌로, 다시 청년미래적금으로 이어지는 동안 정부는 한 가지를 계속 손봤습니다. 소득이 낮을수록, 중소기업에 오래 다닐수록 더 주는 구조로 기울이는 것입니다. 2027년 예산안에서 지방 중소기업 근무자에게 25%를 매기겠다는 것은 청년 자산형성 지원이 지역 인력난 대책과 한 묶음으로 움직이기 시작했다는 신호입니다. 앞으로도 우대 구간은 넓어질 가능성이 크고, 그 혜택은 이미 계좌를 가진 사람부터 적용될 공산이 큽니다. 계좌를 여는 것 자체가 옵션을 사두는 행동에 가깝습니다.
자주 묻는 질문
군 복무를 했는데 나이 기준에 걸립니다
병역 이행 기간은 최대 6년까지 연령 계산에서 빼 줍니다. 1991년 11월 17일생보다 앞서 태어났더라도 복무 기간을 차감했을 때 기준에 들어오면 가입할 수 있습니다. 본인 사례가 애매하면 서민금융진흥원 콜센터에서 확인하는 편이 확실합니다.
총급여가 7000만 원인데 가입해도 의미가 있나요
총급여 6000만 원 초과 7500만 원 이하 구간은 정부 기여금이 붙지 않고 이자소득세 비과세 혜택만 받습니다. 기여금은 없지만 최고 연 7~8% 수준 금리에 세금이 붙지 않는 3년 적금이라는 점은 남습니다. 다른 저축 수단과 비교해 보고 결정하면 됩니다.
신청은 어디서, 문의는 어디로 하나요
가입 요건과 신청 방법은 서민금융진흥원 청년미래적금 웹페이지에서 확인할 수 있고, 문의는 국번 없이 1397번(안내에서 3번)입니다. 구체적인 신청 방법과 갈아타기 세부 절차는 2차 가입 기간이 시작되기 전에 추가로 안내될 예정입니다.
Anthropic published three internal measurements on September 17, 2026, including an index showing Claude now “leads” 26% of the company’s own AI R&D work, up from under 1% in February 2026.
Roughly 30,000 agents were doing research and engineering work at Anthropic at any one time in August 2026; over a billion agent decisions were analyzed and 0.002% (about 1 in 47,000) were blocked in real time.
In the week of July 13-20, about 6% of compute going to AI R&D went to safety work, rising to about 12% for AI-driven AI R&D.
The disclosure lands mid-argument over Dario Amodei’s “pace the frontier” proposal, which Nvidia’s Jensen Huang and the White House have publicly resisted.
Twenty-six percent. That is the share of Anthropic’s own AI research and development work that Claude now “leads” — meaning the model completes most of the task end to end from a high-level prompt while a human supervises. Seven months earlier, in February 2026, that figure was under 1%. Anthropic published the number itself on September 17, alongside two other measurements no frontier lab had previously put in public. The question the disclosure raises is not what the numbers say. It is why a company would volunteer them at all, in the exact week the industry is fighting over whether it should slow down.
The Metric That Measures a Model Building Its Successor
What the R&D Automation Index actually counts
Anthropic built what it calls the Anthropic R&D Automation Index: a catalogue of every kind of AI R&D task done inside the company, each rated for how automated it currently is, then weighted and aggregated. The rating scale comes from Epoch AI and runs from AL0 (no AI involvement) to AL5 (fully autonomous, no human in the loop). AL3 is “AI collaborates” — large chunks of work under close human direction. AL4 is “AI leads” — the model works end to end from a high-level prompt while a human supervises the result.
The August 2026 snapshot reports three things. Claude is not operating fully autonomously for any measured subset of AI R&D work. Claude “leads” 26% of that work. And the share of work sitting at or above “AI collaborates” is above 90%. That last figure is the one most likely to be underweighted in coverage: it means the overwhelming majority of model-building work at a frontier lab already runs with a model inside the loop, not beside it.
How the number was constructed — and where it can break
The methodology is unusually specific for a corporate transparency post. For each week of July 2026, Anthropic randomly sampled 20% of staff in the departments that make up the model R&D loop. A Claude research agent reviewed each sampled person’s week using Slack and internal documentation and listed their tasks, producing roughly 15,000 granular task records. Those were organized into a frozen hierarchical tree of 542 nodes, 378 of them leaves — categories as specific as “eval platform defect diagnosis and fixes” and “serving incident postmortems.” An independent Claude judge then assigned an automation level to each node based only on evidence from that month or earlier.
Anthropic also published its own validation and its own caveats. Staff who own each work area rated their areas blind, without seeing the model’s evidence. The judge model agreed with humans about as often as humans agreed with each other — 59% exact agreement for model-versus-human, 35% for human-versus-human — and model and human ratings landed within one level of each other 97% of the time. The company names the two structural problems plainly: there is no common methodology across labs, and a lab using its own models to judge its own systems risks a judge that makes the same errors as the model it is checking.
Trend Insight — The 26% figure will get the headlines, but the frozen basket is the part that matters operationally. The index measures how automated July 2026’s work has become, not whether new categories of human work have appeared since. Anthropic checked this by rebuilding the tree from January 2026 data and found no rise in novel tasks between baskets — a finding that, if it holds, suggests the structure of model R&D is stable while the labor inside it is being reallocated to machines.
Thirty Thousand Agents, and One Block in Every 47,000 Decisions
Coverage, latency, escalation
The second measurement covers oversight. As of August 2026, approximately 30,000 agents were doing research and engineering work at Anthropic at any one time on its most-used internal platform. The company proposes three metrics any developer could report: coverage (the share of agent actions that pass a monitor), review latency (how quickly a flagged action is reviewed, first by machine and then by a human), and escalation rate (the share of activity blocked, redirected, or flagged).
Two monitor types run in parallel. Online monitors check actions in real time and block irreversible harms — the example given is an agent copying model weights out of Anthropic’s systems. Offline monitors read transcripts after the fact, targeting slow-developing, reversible problems such as signs of misalignment. Coverage is 100% for both. Humans review any blocked action within one week. The offline monitor flags roughly 100,000 transcripts per week, most resolved by classifier review, with approximately 50 per week escalated to human eyes.
Why a tiny percentage is not a small number
Anthropic analyzed over a billion decisions from its research and engineering agents across August 2026 and found that 0.002% of them — about 1 in 47,000 — were blocked by the online monitor. The offline monitor flags one to two transcripts in every thousand for further review. The company frames the scale problem directly: individual agents rarely misbehave, but when millions or billions of agents operate in the economy, even rare events happen regularly.
Two design choices make the monitoring tractable. Each agent is given a persistent individual identity that is not tied to a model, so its record survives model upgrades and every action can be audited per agent over time. And agents communicate through a shared, open messaging system rather than privately, so they can catch each other’s errors and every message can be cross-referenced against transcripts. METR has previously red-teamed the offline monitoring platform independently.
Trend Insight — For anyone running agent fleets in production, the identity decision is the transferable lesson. Tying every artifact to a durable per-agent identity rather than to a model version is what makes retrospective audit possible at all — and it costs almost nothing to adopt early, versus retrofitting it across a system that has already generated millions of untraceable actions.
Six Percent of R&D Compute Went to Safety
One week, sorted by classifier
The third measurement examines a snapshot of how Anthropic used all of its compute from July 13 to July 20, 2026. Every workload was sorted into a small number of categories, then classified as safety work or general AI R&D. The result: about 6% of compute going to AI R&D was allocated to safety, and about 12% of compute going to AI-driven AI R&D was allocated to safety.
Rather than classify all of the week’s almost 10,000 research runs, Anthropic sampled roughly 14% of them, weighted toward the runs that consumed the most compute so the result reflects where compute actually went rather than how many runs there were. Work that advanced capability as much as it advanced safety was counted as AI R&D, not safety — which makes the 6% a deliberately conservative floor rather than a ceiling.
The measurement’s own stated weaknesses
Anthropic is explicit that compute share is an imperfect proxy. Safety research consists largely of individual researchers designing experiments — time-consuming to produce, but not especially compute-intensive to run, so it will always look small next to a frontier training run. Three further limits are named: many underlying workload labels are best-effort and unverified rather than technically enforced; one week is enough to prove the measurement can be made but not enough to establish a trend; and efficiency improvements can lower the safety share without any reduction in safety work actually performed.
The value Anthropic claims for the metric is comparative, not absolute. Because compute is among the most verifiable inputs to AI development, a shared definition of safety work would let outsiders compare like with like across developers and over time — and could become a lever in any future pacing agreement, such as a commitment on the minimum share of compute devoted to alignment and evaluation.
Trend Insight — Anthropic concedes the definitional problem candidly: each developer will be tempted to draw the safety line generously, and the burden of proof should sit with the developer. That concession is the tell. A metric a lab can define in its own favor is only useful once a third party defines it instead — which is precisely the role Anthropic says it is now creating.
Why This Landed in the Middle of a Fight
The pacing argument, and the pushback
The measurements arrive days after Anthropic CEO Dario Amodei published a plan to “pace the frontier,” and Anthropic says it expects these numbers to shift if the industry coordinates on pacing. The company also says it plans to embed independent third-party evaluators from multiple organizations, giving them access to internal processes, systems, and data comparable to what internal risk assessment teams hold — and on September 18, Anthropic named Accenture as its first embedded evaluator.
The reception has not been uniform. Nvidia CEO Jensen Huang has publicly rejected the premise of a slowdown, echoing President Trump’s position that the AI backlash is overstated and regulation unnecessary. On TechCrunch’s Equity podcast, host Anthony Ha noted how quickly industry figures coalesced around Amodei’s proposal — encouraging as consensus, he said, but also grounds for skepticism that it represents genuine steps toward a slowdown. Kirsten Korosec put the alternative reading bluntly: consensus can be a good thing, and it can also be the beginnings of forming a cartel.
Whether markets alone can hold the line
The sharper critique on that episode was structural. Sean O’Kane argued that the usual correctives are not operating here: enforcement appetite is low, and consumer choice is a weak lever in a market that has shifted toward enterprise contracts. “Corporations are not going to pack up and move from Codex to Claude Code just because they disagree on principle,” he said — and the volume of investment capital flowing to frontier labs absorbs whatever losses do materialize.
Which is the context that makes the published numbers interesting regardless of motive. Anthropic’s own framing is that the world should minimize the gap between what frontier labs know and what the public knows, and that any developer could report these three measures today using a public methodology. That claim is now testable in the simplest possible way: the measurements exist, the method is documented, and every other frontier lab has been handed a template it can either match or decline to match in public.
Trend Insight — First-mover transparency is a competitive move as much as a safety one. By publishing a methodology and inviting comparison, Anthropic converts its own disclosure into pressure on rivals, where silence starts to read as an answer. Watch for whether OpenAI or Google DeepMind publish a comparable automation index in the next two quarters — that, not the 26%, is the number to track.
코딩 에이전트 설정 176개를 실측했더니, 컨텍스트 32k에서 관리 유무에 따른 성공률 차이가 35.7%p였다
LLM은 대필 작가가 아니라 교정 편집자다. 모델이 제안한 표현은 한 단어도 쓰지 않는 것이 첫 번째 원칙
Cloudflare는 항목당 8바이트를 6바이트로 줄이고 해시 수를 90% 감축해 전 세계 RAM 100TB를 절감했다
같은 모델을 써도 그것을 감싸는 층을 바꾸면 결과가 달라진다. 이번 주 GeekNews 상위권은 공교롭게도 전부 그 ‘바깥 설계’에 관한 이야기였다. 에이전트를 감싸는 하네스, 글을 감싸는 편집 과정, 요청을 감싸는 라우팅 계층. 세 글 모두 모델이나 알고리듬 자체가 아니라 그것을 둘러싼 구조를 숫자로 검증했다는 공통점이 있다.
설정 176개를 돌려보니 정답이 갈렸다
컨텍스트 관리는 똑똑하게 만드는 게 아니라 안 끊기게 만든다
연구진은 ReAct 실행 루프를 고정한 채 계획 수립, 도구 구성, 컨텍스트 관리 세 가지만 따로 바꿔가며 4개 모델과 2개 벤치마크에서 176개 설정을 비교했다. 평가 과제는 SWE-Bench Verified의 검증된 GitHub 이슈 500건과 Terminal-Bench 2.1의 명령줄 작업 89건이다. 가장 뚜렷한 결과는 컨텍스트 예산이 작을수록 관리 전략의 효과가 커진다는 점이었다. 32k에서는 관리 유무에 따른 평균 성공률 차이가 SWE-Bench 기준 35.7%p였지만, 128k에서는 2.7%p로 줄었다.
그런데 이 차이의 대부분은 모델이 더 똑똑해져서 생긴 것이 아니었다. 관리 없이 돌린 구성의 컨텍스트 초과 실패율은 32k에서 78.7%에 달했고, 관리 전략을 적용한 모든 구성에서는 초과 실패가 0건이었다. 관리는 에이전트의 판단을 바꾸는 장치가 아니라, 코드 수정과 검증까지 도달하도록 실행을 연장해 주는 장치에 가깝다는 뜻이다.
생략 먼저, 요약은 나중. 그리고 복구는 거의 쓰이지 않는다
비용 대비 성능이 가장 좋았던 전략은 오래된 도구 출력을 먼저 짧은 자리표시자로 생략하고, 그래도 한계를 넘으면 그때 요약으로 압축하는 단계형 방식이었다. 8개 모델·벤치마크 조합 가운데 7개에서 작업당 비용이 가장 낮았다. 반면 생략한 원문을 다시 불러오는 복구 기능은 기대에 한참 못 미쳤다. 해당 기능을 켠 64개 설정 중 56.3%가 단 한 번도 호출하지 않았고, 128k에서는 작업당 평균 0.007회에 그쳤다.
계획 기능도 만능이 아니었다. 30B 모델에서는 SWE-Bench 성공률이 13.6%에서 25.2%로 올랐지만, 550B급에서는 성공률이 2.0%p 낮아지는 대신 비용이 약 30% 줄었다. 강한 모델에서 줄어든 실행은 주로 코드 수정 후의 불필요한 재검증이었다. 전용 파일 도구 역시 셸이 서툰 모델에만 도움이 됐다. 550B 모델은 bash만 줬을 때 성공률이 65.8%에서 69.4%로 오르고 작업당 비용은 2.33달러에서 1.11달러로 떨어졌다.
Tech Insight — 하네스 설정을 남의 ‘모범 사례’에서 복사해 오면 손해 볼 가능성이 크다. 약한 모델에게 계획과 전용 도구는 보조 바퀴지만, 강한 모델에게는 같은 장치가 비용만 늘리는 족쇄가 된다. 사내 에이전트를 운영 중이라면 모델을 교체할 때마다 하네스 기본값도 함께 재측정하는 것이 맞다.
글은 직접 쓰고, 트집만 맡겨라
원칙 1. 모델이 제안한 표현은 한 단어도 쓰지 않는다
필자의 전제는 단순하다. 아무리 다듬어도 많은 독자는 LLM이 만든 문단을 글이 아니라 생성된 출력물로 받아들인다는 것이다. 그래서 순서를 뒤집는다. 먼저 직접 쓰고, 그다음 좋은 모델에게 결함을 찾게 한다. 최첨단 모델은 듣기 좋은 표현을 고르는 데 매우 능하지만, 그 문장들은 하나같이 잡지 헤드라인처럼 나온다. 헤드라인 하나는 좋아도 헤드라인 수십 개로 이어 붙인 글은 읽는 사람에게 이상하게 느껴진다.
그래서 마음에 들거나 기존 표현보다 낫다고 확신하더라도 예외를 두지 않는 것을 안전장치로 삼는다. 모델이 글을 획일적인 가공품으로 바꾸는 모든 경로를 사람이 빠짐없이 식별할 수 있다는 전제에 기대지 않겠다는 뜻이다.
원칙 2. 칭찬을 금지어로 설정한다
두 번째 원칙은 더 미묘하다. LLM은 문구뿐 아니라 칭찬으로도 글을 바꾼다. 초안에는 반드시 덜어낼 문단과 흐트러진 주제 흐름이 있는데, 모델은 구조부터 연결부, 비유, 인용까지 칭찬하기 쉽다. 그 격려가 초안의 선택을 고수하게 만들고, 다시 생각하고 고쳐 쓰는 과정을 건너뛰게 한다. 필자는 격려를 명시적으로 금지하고, 그래도 새어 나오는 칭찬을 계속 경계하라고 말한다.
모델에 맡길 일은 따로 있다. 수동태 남용, 동사의 명사화, 동작이 드러나지 않는 문장, 반복되는 표현, ‘매우’나 ‘실제로’ 같은 불필요한 수식어, 자리만 바꿔도 명료해지는 문단 후보를 찾는 일이다. 수정은 직접 하고, 원문과 수정본 비교는 편집 맥락을 모르는 별도의 모델에 맡긴다. 방금 고쳤다는 사실을 아는 모델은 사용자가 수정본을 고르길 원한다는 것까지 알아채기 때문이다.
Tech Insight — 이 원칙은 개발 문서와 커밋 메시지에 그대로 적용된다. 댓글에서 한 개발자는 커밋 메시지와 PR 설명을 다시 직접 쓰기 시작한 뒤 에이전트가 만든 코드를 훨씬 깊이 이해하게 됐다고 말한다. 생성 비용이 0에 가까워질수록, 직접 쓰는 행위 자체가 곧 리뷰 행위가 된다.
8바이트를 6바이트로 줄여 100TB를 아꼈다
해시를 많이 뿌릴수록 좋다는 상식이 무너졌다
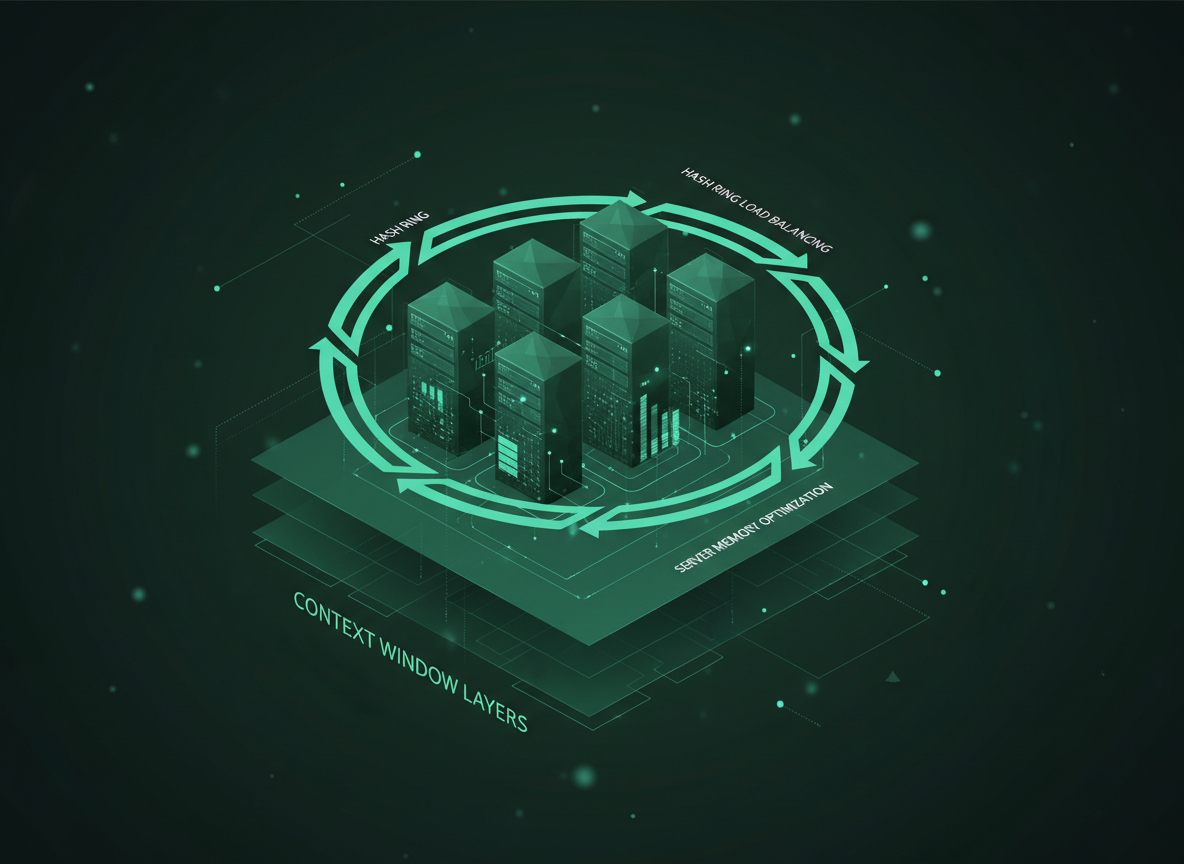
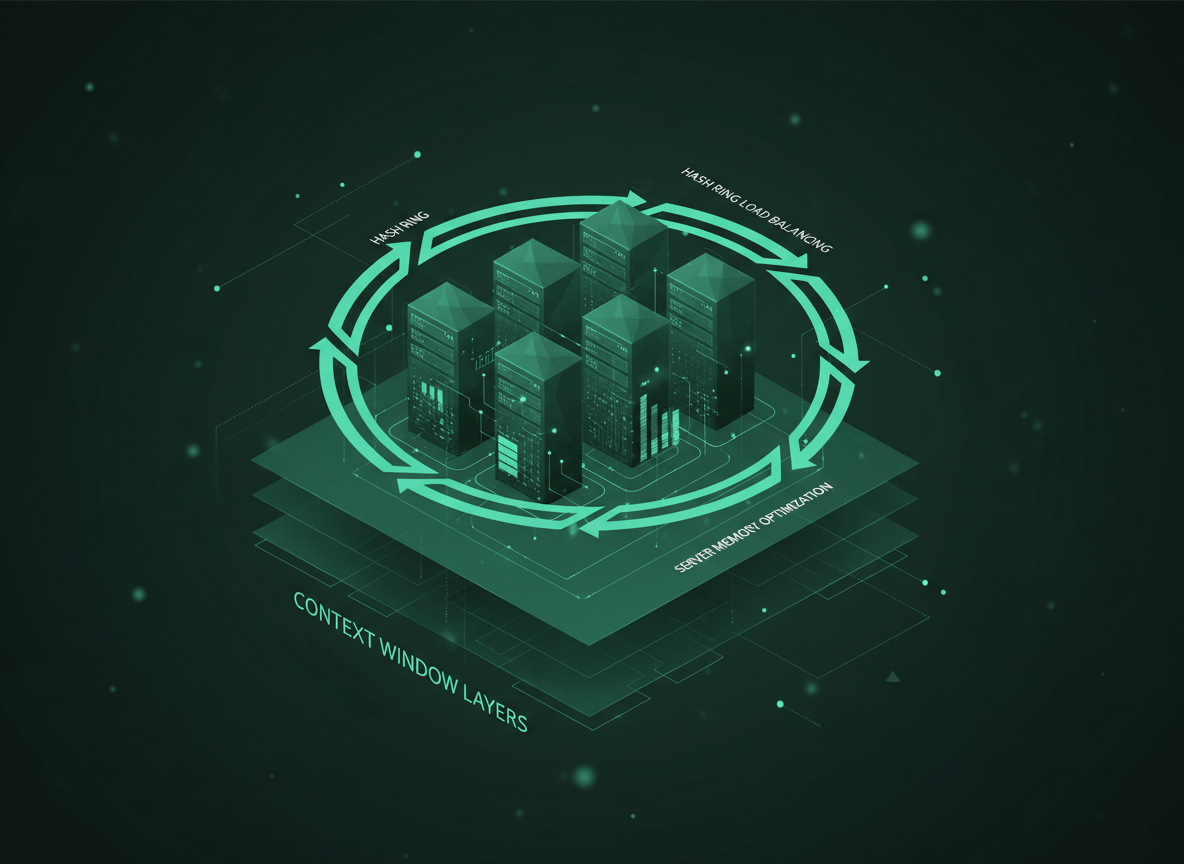
Cloudflare는 캐시 요청을 서버로 분배하는 내부 라우터 PBR에서 예상보다 큰 메모리 사용량을 발견했다. 원인은 일관된 해싱 구현이었다. 서버 100대 기준으로 서버당 해시가 하나뿐이면 담당 구간의 변동계수가 약 99%에 달해, 어떤 서버는 목표의 두 배를 처리하고 어떤 서버는 거의 놀게 된다. 그래서 NGINX도 Pingora도 서버당 기본 160개를 쓴다. 여기에 디스크 용량 가중치가 곱해지고, 규정 준수와 캐시 기능 조합마다 별도의 링이 생기면서 해시 데이터만 일부 경우 6GB까지 불어났다.
성능 팀은 이 상수를 다시 계산했다. 서버당 해시가 k개일 때 변동계수는 √((N-1)/(Nk+1))로 줄어든다. 기본값 160에 가중치 625를 곱해 서버당 10만 개가 됐을 때, 마지막에 추가한 9만 개가 줄여주는 오차는 0.7%에 불과했다. 게다가 32비트 해시 공간에서는 생일 역설 때문에 충돌이 빠르게 늘어난다. 서버 2,048대 데이터센터 시뮬레이션에서는 해시를 1만 개에서 10만 개로 늘리는 구간에서 오차가 오히려 증가했다. 결론은 해시 수 90% 감축이었다.
Rust 정렬 규칙을 피해 항목당 2바이트를 벌었다
기존 Point 구조체는 hash를 u32, index를 u32로 담아 8바이트를 차지했다. PBR이 동시에 6만 5천 대를 넘는 서버를 조정할 일은 없으니 인덱스는 u16이면 충분한데, 막상 u16으로 바꿔도 4바이트 정렬 요구 때문에 구조체 크기는 그대로 8바이트였다. repr(packed)는 알려진 안전성 문제가 있어, 대신 [u8; 6] 배열과 접근자 메서드로 바꿨다. 가독성은 떨어지지만 두 방식은 같은 기계어로 컴파일된다. 항목당 8바이트를 6바이트로 줄여 해당 자료구조의 메모리를 25% 절감했다.
전환 과정도 참고할 만하다. 해시 링이 바뀌면 요청 목적지가 바뀌면서 전 세계 캐시가 사실상 무효화되고 원본 서버로 트래픽이 몰린다. 그래서 기존 링과 축소된 새 링을 동시에 메모리에 올려둔 채, 새 링으로 보낼 트래픽 비율과 적용 데이터센터 범위를 각각 따로 제어하며 단계적으로 옮겼다. 문제가 생기면 재배포 없이 기존 링으로 되돌릴 수 있었고, 전환율이 100%에 도달한 뒤 구형 경로를 제거하자 전 세계 메모리 사용량이 약 100TB 줄었다.
Tech Insight — 이 최적화의 본체는 Rust가 아니라 기본값을 의심한 행위다. 160이라는 숫자는 NGINX 시절부터 아무도 다시 계산하지 않은 상수였다. 규모가 커질수록 남이 정해 둔 기본값 하나가 그대로 예산이 된다. 세 번째 글도 결국 첫 번째 글과 같은 말을 하고 있는 셈이다.
신청 절차는 없다. 전부 가격에 자동 반영되므로, 독자가 할 일은 언제·어디서 주유하느냐를 고르는 것뿐.
9월 말에 끝날 예정이던 유류세 인하가 두 달 더 연장됐다. 여기까지는 몇 번 반복된 뉴스다. 그런데 이번 발표에는 유효기간이 나흘짜리인 조치가 하나 끼어 있다. 추석 연휴 동안 전국 고속도로 주유소 기름값을 리터당 100원 내리는 것. 명절에 장거리를 뛰는 사람이라면 이 나흘을 어떻게 쓰느냐로 수만 원이 갈린다.
날짜부터 정리 — 무엇이 언제까지인가
구윤철 부총리 겸 재정경제부장관은 9월 18일 비상경제본부 회의 겸 경제관계장관회의에서 ’10월 이후 유류세 운용방안’과 ‘추석 고속도로 주유소 유류가격 및 전기차 충전요금 할인방안’을 함께 확정했다. 성격이 다른 세 가지 조치가 한 번에 발표됐기 때문에, 기한을 섞어서 기억하면 손해를 본다.
조치
내용
기간
유류세 인하 연장
휘발유 15%, 경유·부탄 25% 인하 유지
~11월 30일
고속도로 주유소 할인
9월 17일 대비 리터당 100원 인하
9월 24~27일
전기차 충전요금 할인
재생에너지 공급이 많은 낮 시간대 할인
추석 기간
석유 최고가격(10차)
9차와 동일하게 동결
9월 19일 0시부터 4주
정책 분석 — 이번 연장은 ‘경기 부양’이 아니라 ‘방어’에 가깝다. 정부가 회의 이름을 비상경제본부로 유지하고, 중동 정세 불확실성 확대를 연장 사유로 명시한 것이 단서다. 유류세는 세수와 직결되는 항목이라 정부 입장에서는 오래 끌수록 부담이 커진다. 그런데도 2개월만 끊어서 연장한 것은, 유가가 진정되면 곧바로 환원 논의로 넘어가겠다는 뜻으로 읽는 편이 안전하다. 즉 독자 입장에서 지금의 리터당 122원은 ‘기본값’이 아니라 ‘한시적으로 빌린 값’이다.
내 기름값에 붙어 있는 할인은 얼마인가
리터당 실제 차액
인하율 15%, 25%라는 숫자는 체감이 안 된다. 부가가치세까지 포함해 리터당 세금이 얼마나 줄었는지로 보면 계산이 바로 된다.
유종
인하율
리터당 인하 효과
휘발유
15%
122원
경유
25%
145원
부탄(LPG)
25%
51원
사례 계산 — 연간으로 환산하면
리터당 인하폭에 각자의 주행거리를 곱해 보면 규모가 드러난다. 아래는 위 표의 인하폭을 그대로 적용한 예시 계산이다.
연 15,000km · 연비 12km/L 휘발유 승용차 → 연 1,250L → 약 15만 2,000원 절감
연 30,000km · 연비 8km/L 경유 화물차 → 연 3,750L → 약 54만 3,000원 절감
이번 2개월 연장분만 떼어 보면, 위 승용차 기준 약 208L → 약 2만 5,000원
정책 분석 — 여기서 갈리는 지점이 있다. 유류세 인하는 자영업 화물·배송 차주에게 훨씬 크게 작동한다. 경유는 인하폭 자체가 휘발유보다 크고, 주행거리도 몇 배다. 게다가 영업용 화물차의 유가보조금은 유류세 인하와 별도로 지급되는 제도라 한쪽을 받는다고 다른 쪽이 깎이지 않는다. 두 가지를 같이 받고 있다면 연 단위 체감액은 위 계산보다 커진다. 반대로 LPG 차량은 인하폭이 리터당 51원이라, 같은 25% 인하라도 실익은 경유의 3분의 1 수준이다.
추석 나흘, 어디서 넣어야 가장 싼가
고속도로 주유소가 역전된다
평소 고속도로 휴게소 주유소는 시내보다 비싸다는 인식이 있다. 그런데 9월 24일부터 27일까지는 한국도로공사가 관리하는 전국 고속도로 주유소 가격을 9월 17일 대비 리터당 100원 내린다. 나흘 동안만 가격 순서가 뒤집힐 수 있다는 뜻이다.
60리터를 채운다면 한 번에 6,000원, 왕복 두 번 주유하면 1만 2,000원 차이다. 귀성·귀경을 모두 고속도로로 한다면 경로에 휴게소 주유소를 넣어 두는 편이 유리하다.
최고가격제 — 상한선을 외워 두면 바가지를 피한다
산업통상부는 9월 19일 0시부터 4주간 적용되는 10차 석유 최고가격을 9차와 같은 수준으로 동결했다. 리터당 휘발유 1,784원, 경유 1,773원, 등유 1,380원이다. 명절 성수기에 이 선을 크게 웃도는 표시가격을 봤다면, 그 주유소는 그냥 지나치는 쪽이 낫다.
전기차는 시간대를 옮기는 게 할인이다
전기차 이용자에게는 별도의 조치가 붙었다. 추석 기간 중 태양광 등 재생에너지 공급이 풍부한 낮 시간대에 충전요금을 할인한다. 밤에 습관적으로 꽂아 두던 사람이라면, 연휴만큼은 낮으로 옮기는 것이 그대로 절감이 된다.
30초 자격 체크
차량을 운행한다 → 유류세 인하는 소득·나이·지역 조건이 없다. 전 국민 자동 적용.
추석에 고속도로를 탄다 → 9월 24~27일, 도로공사 관리 주유소에서 리터당 100원 추가 인하.
경유 화물차로 영업한다 → 유류세 인하 + 유가보조금, 둘 다 해당된다.
전기차를 탄다 → 연휴 충전은 밤이 아니라 낮 시간대로.
12월 이후에도 지금 가격일 거라 가정한다 → 인하 조치는 11월 30일까지만 확정됐다.
정책 분석 — 신청에서 막힐 일이 없는 대신, 이 정책은 ‘몰라서 놓치는’ 구조다. 할인은 카드 청구나 환급이 아니라 주유소 표시가격에 이미 반영되어 나오기 때문에, 영수증만 봐서는 얼마를 아꼈는지 보이지 않는다. 그래서 사람들이 평소와 같은 주유소를 같은 시간에 간다. 가장 흔한 실수 두 가지는 이렇다. 첫째, 고속도로 할인 대상은 한국도로공사가 관리하는 주유소로 발표됐다는 점 — 국도변 주유소나 민간 위탁 주유소까지 자동으로 같지는 않다. 둘째, 나흘 할인을 노리고 연휴 직전에 탱크를 비워 두는 것은 위험하다. 명절 정체를 감안하면 잔량 경고등을 켠 채 고속도로에 오르는 쪽이 절감액보다 비싼 대가를 치를 수 있다.
안 챙기면 무엇을 잃고, 다음은 어떻게 되나
기회비용 — 나흘과 두 달
유류세 인하는 가만히 있어도 적용되니 ‘놓칠 수 없는’ 혜택처럼 보인다. 하지만 놓칠 수 있는 부분은 따로 있다. 추석 나흘간의 리터당 100원은 그 기간에 그 주유소에서 넣은 사람만 가져간다. 왕복 주유 기준 1만 2,000원, 두 대를 운행하는 가구라면 2만 원대다. 연휴 동선을 짤 때 30초만 쓰면 확보되는 금액이고, 안 쓰면 그대로 사라진다.
더 큰 쪽은 두 달이다. 유가가 오르는 국면에서 인하율이 유지된다는 것은, 소비자가 체감하는 가격 상승폭이 그만큼 눌린다는 의미다. 앞의 승용차 예시로 2개월에 약 2만 5,000원, 경유 화물차라면 같은 기간 9만 원을 넘는다.
다음 분기점은 11월 말
정부는 이번에도 2개월 단위로 끊었다. 관행대로라면 11월 하순에 다시 한 번 결정이 나온다. 선택지는 세 가지다. 재연장, 인하율 단계적 축소, 전면 환원. 국제유가가 어느 방향으로 가는지가 사실상 변수 전부다. 지금 시점에서 독자가 할 수 있는 대비는 단순하다. 12월 이후 유류비를 현재 가격 기준으로 잡아 두지 않는 것이다. 인하가 끝나면 휘발유는 리터당 122원, 경유는 145원이 한 번에 붙는다.
정책 분석 — 유류세 인하는 ‘받는 정책’이 아니라 ‘안 내는 정책’이라 정치적으로 끝내기가 어렵다. 한 번 내리면 되돌릴 때 반드시 체감 인상으로 읽히기 때문이다. 동시에 정부 입장에서는 세수 구멍이 매달 누적된다. 이 긴장 때문에 최근 몇 년간 한국의 유류세 정책은 ‘2~4개월씩 끊어 연장하되, 유가가 내려간 구간에서 인하율을 조금씩 깎는’ 패턴을 반복해 왔다. 그래서 연장 발표 자체보다 인하율이 유지됐는지, 낮아졌는지를 보는 게 정확하다. 이번에는 휘발유 15%, 경유·부탄 25%가 그대로 유지됐다. 유가가 오르는 국면이라 축소 카드를 꺼내기 어려웠다는 신호다.
자주 묻는 질문
따로 신청하거나 등록해야 하나
아니다. 유류세 인하도, 추석 고속도로 주유소 할인도 판매가격에 반영되는 방식이다. 신청서, 카드 등록, 사후 환급 절차가 모두 없다. 결정할 것은 언제 어디서 주유하느냐뿐이다.
모든 주유소가 리터당 100원 싸지는 건가
그렇지 않다. 이번 할인은 한국도로공사가 관리하는 전국 고속도로 주유소를 대상으로, 9월 17일 가격 대비 리터당 100원을 내리는 조치다. 기간도 9월 24일부터 27일까지다. 일반 시내 주유소나 국도변 주유소는 별개이며, 그쪽은 유류세 인하분만 반영된다.
최고가격 1,784원보다 비싸게 팔면 어떻게 되나
10차 석유 최고가격은 9월 19일 0시부터 4주간 리터당 휘발유 1,784원, 경유 1,773원, 등유 1,380원으로 동결됐다. 이는 정부가 지정한 상한 가격이므로, 표시가격이 이를 넘는다면 소비자 입장에서는 다른 주유소를 택하는 것이 합리적이다. 가격 비교는 주유 전 실시간 가격 정보를 확인하는 쪽이 정확하다.
오라클의 AI 클라우드 수주잔고(RPO)가 6,380억 달러(약 880조 원)로 1년 만에 363% 폭증 — 한 분기에만 약 117조 원이 쌓였다.
그런데 잉여현금흐름(FCF)은 5개 분기 연속 적자. 연간 -237억 달러(약 -33조 원), 자본지출은 556억 달러(약 77조 원)로 두 배 이상 늘었다.
이 수주잔고의 약 절반이 ‘오픈AI’ 한 곳에 걸려 있다. 월가는 오라클을 ‘오픈AI 대리 투자’라 부른다.
핵심 교훈: 계약 규모(수주)와 손에 쥐는 현금은 다른 타임라인이다. AI 인프라 사업은 마진 구조부터 다르게 봐야 한다.
9월 10일(현지시간) 장 마감 후 공개된 오라클(Oracle)의 분기 실적에서, 숫자 하나가 시장을 얼어붙게 만들었습니다. 아직 매출로 잡히지도 않은 ‘수주잔고’가 6,380억 달러, 우리 돈으로 약 880조 원. 1년 만에 363% 폭증했고, 한 분기에만 850억 달러(약 117조 원)가 새로 쌓였습니다. AI 클라우드 계약이 이 정도로 몰린 회사는 지금까지 없었습니다. 그런데 같은 발표 안에, 정반대 숫자가 숨어 있었습니다. 오라클의 잉여현금흐름은 5개 분기 연속 마이너스. 역대 최대 규모의 수주를 따내고도, 정작 손에 쥐는 현금은 계속 빠져나가고 있다는 뜻입니다. 이 모순이 바로 2026년 AI 비즈니스의 가장 날카로운 질문입니다. (환율은 약 1,380원/달러 기준)
880조 원, 이건 ‘매출’이 아니라 ‘수주잔고’입니다
수주잔고(RPO)가 대체 뭐길래
먼저 이 880조 원의 정체를 정확히 짚어야 합니다. 이건 오라클이 ‘이미 번 돈’이 아닙니다. 회계 용어로 RPO(Remaining Performance Obligations, 잔여 이행 의무), 즉 계약은 체결했지만 아직 서비스를 제공하지 않아 매출로 인식되지 않은 ‘예약된 미래 매출’입니다. 식당으로 치면 예약 장부에 찍힌 예약 건수이지, 계산대에 들어온 현금이 아닙니다. 그중 일부만 향후 12개월 안에 실제 매출로 전환됩니다.
오라클은 본래 데이터베이스와 기업용 소프트웨어 회사입니다. 전 세계 43만 개가 넘는 설치 기반 고객에서 나오는 끈끈한 구독형 매출이 뼈대이고, 블렌디드 매출총이익률이 68.5%에 이르는 탄탄한 프랜차이즈입니다. 그런 회사가 지금 창사 이래 가장 공격적인 투자 사이클에 들어섰습니다. 클라우드 인프라 매출은 전년 대비 세 자릿수로 뛰었고, 그 성장의 ‘증거’가 바로 이 폭발적인 RPO입니다.
AI Biz Insider 분석 — 수주잔고가 크다는 건 ‘미래 매출의 가시성’이 좋다는 뜻입니다. 투자자에게는 안심 재료죠. 하지만 가시성은 현금흐름과 동의어가 아닙니다. 예약이 아무리 밀려도, 주방을 먼저 증설하느라 돈이 나가면 통장은 마릅니다. 오라클의 이야기는 바로 그 간극에 관한 것입니다.
그 절반이 ‘오픈AI’ 한 곳에 걸려 있다
더 예민한 지점은 집중도입니다. 이 880조 원 수주잔고의 약 절반이 오픈AI 한 곳에서 나옵니다. 오픈AI가 오라클과 맺은 다년 계약은 약 3,000억 달러(약 414조 원) 규모로 알려져 있습니다. 투자 매체 배런스(Barron’s)가 오라클 주식을 아예 ‘오픈AI에 대한 대리 투자(proxy)’라고 부를 정도입니다.
문제는 오픈AI 자신도 아직 적자 기업이고, 이 거대한 지출을 감당하기 위해 계속해서 외부 자금을 조달해야 하는 처지라는 점입니다. 오라클의 미래 매출 절반이, ‘아직 흑자를 못 낸 고객이 앞으로도 계속 돈을 낼 수 있느냐’에 달려 있는 구조인 셈입니다. 성장의 엔진이자 동시에 가장 큰 리스크가 한 이름에 묶여 있습니다.
그런데 현금은 왜 마르나
5개 분기 연속 마이너스 현금흐름
이제 반대편 숫자를 봅시다. 오라클의 영업활동 현금흐름은 사상 최대인 약 320억 달러(약 44조 원)를 기록했습니다. 장사 자체는 역대급으로 잘했다는 뜻입니다. 그런데 잉여현금흐름(FCF)은 연간 -237억 달러(약 -33조 원)로, 무려 5개 분기 연속 적자였습니다. 벌어들인 현금보다 더 많은 돈이 밖으로 나가고 있다는 얘기입니다.
범인은 자본지출(CapEx)입니다. 2026 회계연도 자본지출은 556억 달러(약 77조 원)로 1년 만에 두 배 이상 불어났습니다. 데이터센터를 짓고 GPU를 사들이는 데 들어간 돈입니다. 게다가 회사는 올해 순 자본지출 가이던스를 700억~950억 달러(약 97조~131조 원)로 제시했습니다. 지출은 줄기는커녕 더 커집니다.
계약은 ‘보이는데’ 현금은 ‘안 들어온다’
핵심은 순서입니다. AI 클라우드는 계약을 따낸 뒤 데이터센터와 GPU를 먼저 지어야 매출과 현금이 들어오기 시작합니다. 그래서 수주가 폭증하는 국면일수록, 역설적으로 현금은 더 빠르게 빠져나갑니다. 일부 애널리스트는 오라클의 잉여현금흐름 흑자 전환 시점을 빨라야 2029 회계연도로 봅니다. 다만 완충 장치도 있습니다. 대형 계약에 들어가는 하드웨어 중 약 750억 달러(약 104조 원)어치는 고객이 선지급하거나 직접 공급해, 부담의 일부를 오라클 장부 밖으로 넘겨놓았습니다.
AI Biz Insider 분석 — ‘AI로 돈을 번다’는 말은 두 단계로 쪼개야 합니다. 1단계는 계약(수주), 2단계는 현금 회수입니다. 지금 AI 인프라 시장은 대부분 1단계에서 축포를 쏘고 있지만, 진짜 승부는 2단계에서 갈립니다. 계약 잔고가 얼마나 빨리 ‘청구 가능한 현금’으로 바뀌느냐 — 오라클 실적에서 시장이 실제로 노려본 숫자는 880조가 아니라 바로 이 전환 속도였습니다.
진짜 문제는 ‘이익률’이 다르다는 것
한 겹 더 들어가면 마진 문제가 있습니다. 오라클의 블렌디드 매출총이익률은 68.5%지만, 가장 빠르게 크는 AI 인프라 사업의 총이익률은 30~40%대에 불과합니다. AI 매출 비중이 커질수록 회사 전체의 이익률은 오히려 눌리는 구조입니다. 클라우드 인프라 시장에서 오라클의 점유율은 약 3%로, AWS 32%·애저 23%·구글 클라우드 11%에 한참 못 미칩니다. 규모로 정면 승부하는 게 아니라, GPU 워크로드에 특화된 틈새로 파고드는 전략입니다.
한국 경영자가 여기서 챙겨야 할 3가지
1) ‘수주 = 현금’이 아니다
큰 계약을 따내면 회사는 축포를 쏩니다. 하지만 매출 인식 시점과 현금 유입 시점은 전혀 다른 타임라인 위에 있습니다. 특히 설비나 인력 같은 선투자가 큰 사업일수록, 계약과 현금 사이의 간극은 더 벌어집니다. 세계 최대 SW 기업조차 880조 수주 앞에서 현금이 마르는데, 규모가 작은 기업이라면 이 간극이 곧 유동성 위기로 직결될 수 있습니다. 계약의 ‘크기’보다 현금 ‘전환 속도’를 먼저 보십시오.
2) AI 인프라는 ‘이익률이 다른 사업’이다
AI를 붙이면 매출은 늘지만, 마진은 기존 사업보다 낮을 수 있습니다. 오라클이 68%에서 30%대로 희석되는 것처럼요. AI 신사업을 검토할 때는 ‘매출 성장’과 ‘마진 구조’를 반드시 분리해서 봐야 합니다. 매출 곡선만 보고 뛰어들면, 규모는 커지는데 이익은 오히려 얇아지는 함정에 빠질 수 있습니다.
3) ‘단일 고객 의존’은 양날의 검이다
오라클 미래 매출의 절반이 오픈AI에 묶여 있다는 건, 그 고객의 성장과 리스크에 회사 운명이 함께 종속된다는 뜻입니다. 매출이 특정 대형 고객 한 곳에 쏠려 있다면, 그건 안정적인 ‘앵커 고객’이 아니라 집중 리스크일 수 있습니다. 지금 우리 회사의 매출 집중도(상위 고객 비중)를 한번 점검해 보시길 권합니다.
AI Biz Insider 분석 — 오라클의 딜레마는 남의 이야기가 아닙니다. ‘AI 투자를 지금 얼마나, 어떤 속도로 할 것인가’는 대기업만의 고민이 아니라 중소·스타트업의 생존 문제이기도 합니다. 핵심은 하나입니다. 화려한 계약 규모가 아니라, 그 계약이 현금으로 돌아오는 시점과 마진을 냉정하게 계산하는 회사가 결국 살아남습니다.
미국 NSA·FBI·CISA가 9월 8일 공동 사이버보안 권고를 내고 딥시크·문샷AI·알리바바·미니맥스·스텝펀·Z.AI 등 중국 AI 6곳을 “산업적 규모의 증류(distillation)” 혐의로 지목했다.
2024년 이후 클로드·GPT·제미나이·그록 등 미국 프런티어 모델에서 “수십억 토큰”을 뽑아내 자사 모델을 학습시켰다는 것이 핵심 주장이다.
논란의 초점은 값싼 중국 오픈모델의 원가 구조다. 딥시크의 560만 달러 학습 비용 주장이 증류 데이터 비용을 민 수치라는 지적이 나왔다.
값싼 중국 모델을 쓰고 있다면, 지금 우리 AI 스택의 모델 출처·약관·규제 리스크부터 점검해야 한다.
싼 맛에 도입한 AI가 어느 날 미국 정부의 요주의 명단에 올랐다면 어떻게 될까. 2026년 9월 8일(현지시간), 미국의 3대 안보·수사 기관이 이례적인 공동 권고문을 발표했다. 대상은 국내 개발 현장에서도 이미 익숙한 중국 AI 기업들이다. 단순한 기술 자존심 싸움이 아니라, AI를 도입한 모든 기업의 공급망 리스크로 번질 수 있는 사안이라는 점에서 경영자의 시선이 필요하다.
미국 3대 기관이 지목한 중국 AI 6곳
‘증류(distillation)’가 뭐길래
NSA(국가안보국), FBI(연방수사국), CISA(사이버보안·인프라보안국)는 9월 8일 공동 사이버보안 권고(문서번호 AA26-251a)를 통해 딥시크, 문샷AI, 알리바바, 미니맥스, 스텝펀, Z.AI 여섯 곳을 지목했다. 이들이 “산업적 규모의 공격적이고 악의적인 증류 활동”으로 미국 프런티어 모델의 독점 기능과 역량을 빼냈다는 것이다.
증류란 작은 모델이 큰 모델에 반복적으로 질의해 그 응답을 학습하고 성능을 끌어올리는 기법이다. 기술 자체는 합법적으로도 쓰이지만, 상용 모델 제공사는 대개 약관으로 이를 금지한다. 막대한 학습 투자를 보호하기 위해서다. 권고문은 중국 기업들이 정식 API, 원격 클라우드, 제3자 aggregator, 그리고 이른바 ‘중계소(transfer station)’라 불리는 회색시장 프록시를 통해 지역 제한과 약관을 우회했다고 주장한다. 대상 모델로는 앤스로픽 클로드, 오픈AI GPT, 구글 제미나이, xAI 그록이 거명됐고, 2024년 이후 “수백만 건의 요청에 걸쳐 수십억 토큰”이 빠져나갔다고 명시했다.
AI Biz Insider 분석 — 핵심은 미국이 이를 개별 사건이 아니라 중국 AI 개발 전략의 “핵심(the core)”으로 규정했다는 점이다. 일회성 약관 위반이 아니라 구조적 문제로 본다는 신호이며, 이는 향후 규제의 강도를 가늠하게 한다.
왜 ‘값싼 중국 모델’과 연결되나
딥시크 ‘560만 달러’의 진실 공방
권고문에서 가장 사업적으로 민감한 대목은 원가다. 딥시크는 R1·V3 모델을 학습시키며 GPT-4, GPT-5, 여러 클로드 버전의 추론·에이전트 기능을 표적으로 삼았다고 지목됐다. 문샷AI는 클로드 ‘페이블(Fable)’에서 상당량의 데이터를 뽑아 최신급 모델 키미 K3를 학습시켰고, 이전 모델 키미 K2는 GPT-4o 데이터를 활용했다는 주장도 담겼다.
미국 당국은 딥시크가 내세운 560만 달러라는 학습 비용이 증류로 확보한 데이터 비용을 제외한 수치여서 오해를 부른다고 지적했다. 이는 단순한 자존심 다툼이 아니다. 2025년 초 딥시크가 “적은 컴퓨팅으로 최고 성능”을 내세우자 인프라에 수십억 달러를 쏟은 투자자들이 흔들렸던 바로 그 사건의 재점화다. 알리바바의 Qwen 계열처럼 고품질 오픈모델이 무료로 배포되는 흐름 역시, 유료 접근에 의존해 아직 대규모 적자를 감수 중인 미국 기업들에는 직접적인 위협으로 작용한다.
AI Biz Insider 분석 — 기업이 냉정하게 볼 지점은 이것이다. 중국 오픈모델의 낮은 가격이 순수한 기술 효율 때문인지, 아니면 미국 주장처럼 원가에 반영되지 않은 무언가 때문인지에 따라 ‘싸다’는 판단의 전제 자체가 흔들린다.
한국 경영자가 지금 점검할 세 가지
우리 AI 스택의 ‘출처’를 아는가
첫째, 모델 출처를 파악하라. 사내 챗봇, 코드 어시스턴트, 그리고 도입한 SaaS의 AI 부가 기능이 실제로 어떤 모델 위에서 돌아가는지 확인해야 한다. 적지 않은 툴이 내부적으로 딥시크·Qwen·Kimi 같은 오픈모델을 쓰면서도 이를 명시하지 않는다.
둘째, 약관과 규제 리스크를 점검하라. 미국이 증류를 지식재산·안보 문제로 규정하기 시작한 만큼, 앞으로 수출통제·공공조달 배제·클라우드 차단 등으로 번질 여지가 있다. 정부나 대기업 납품, 미국 시장을 겴냥한 서비스라면 특히 민감하게 봐야 한다.
셋째, 대체 계획을 마련하라. 특정 모델이 갑자기 막혀도 서비스가 멈추지 않도록, 모델을 갈아끼울 수 있는 추상화 계층과 대안 벤더를 미리 확보해 두는 편이 안전하다. 하나의 저가 모델에 서비스 전체를 묶어 두는 것은 지금 시점에서 분명한 리스크다.
AI Biz Insider 분석 — 권고문의 ‘중계소가 프런티어 모델을 공식가의 몇 분의 일 가격에 재판매한다’는 대목을 흘려듣지 말자. 협력사나 도입 툴이 비정상적으로 싼 API를 쓰고 있다면, 그 경로 자체가 추적 불가능한 회색 공급망일 수 있다.
균형을 위해 — 미국 기업도 예외는 아니다
다만 이 사안을 한쪽 시각으로만 볼 필요는 없다. 증류 논란은 미국과 중국 양쪽에서 오갔다. 오픈AI는 2025년 초 딥시크 부상 직후 마이크로소프트와 함께 자사 기술을 증류한 것으로 의심되는 계정들을 차단했다고 밝혔고, 앤스로픽도 올해 딥시크·문샷·미니맥스를 상대로 유사한 의혹을 제기했다.
반대로 일론 머스크는 자신이 오픈AI를 상대로 제기한 소송의 반대신문 과정에서, xAI 모델 학습에 오픈AI의 출력을 활용했음을 인정한 바 있다. 중국 측은 오히려 미국 기업이 중국 모델을 증류한다고 반박하며, 관련 제재가 나올 경우 대응하겠다는 뜻을 내비쳤다. 요컨대 증류는 특정 국가만의 문제라기보다, 프런티어 모델 시대가 만든 공통의 회색지대에 가깝다. 기업이 고민할 것은 어느 편을 드느냐가 아니라, 이 회색지대가 만들어 낼 규제·평판 리스크를 어떻게 관리하느냐다.
GPT-6 Astra 등장으로, 그동안 쌓아둔 스킬·AGENTS.md·작업 프롬프트를 다시 손봐야 할 때가 왔다
VoiceStudio — 계정도 API 키도 없이 내 PC에서 5~15초 샘플로 목소리를 복제하는 오픈소스 스튜디오
28년 경력 개발자가 MIT를 버리고 EUPL로, 다시 불붙는 오픈소스 라이선스 논쟁
개발 도구가 하루가 다르게 똑똑해지는 지금, ‘한 번 잘 세팅해두면 계속 잘 굴러간다’는 믿음이 흔들리고 있습니다. 오늘 GeekNews TOP3는 공교롭게도 한 방향을 가리킵니다. 그동안 옳다고 믿어온 설정과 방식을, 지금 다시 의심하라는 것입니다. 코딩 에이전트의 프롬프트부터 로컬 음성 AI, 그리고 오픈소스 라이선스까지 개발자의 ‘기본값’이 흔들리는 세 가지 신호를 정리했습니다.
그동안 공들인 프롬프트, 지금이 갈아엎을 때
왜 ‘잘 만든 설정’이 오히려 발목을 잡나
코딩 에이전트의 성능이 올라가면서, 예전에는 반드시 필요했던 세세한 유도와 보조 절차가 이제는 오히려 방해가 되는 경우가 늘고 있습니다. 핵심은 누적입니다. 지난 1년간 좋은 결과를 끌어내려고 프로젝트마다 덧붙여 온 지시들이 GPT-6 Astra 기준에서는 과잉이 될 수 있다는 것입니다. 스킬 설명은 ‘언제 써야 하는지’를 분명히 하되 최대한 짧아야 합니다. 설명이 길고 많아지면 모델이 각 설명을 덜 읽게 되어, 정작 맞는 스킬을 고르기 어려워집니다. 여러 작업 흐름을 담은 스킬이라면 루트 문서는 최소한의 안내만 두고, 필요한 보조 문서와 스크립트로 연결하는 점진적 공개(progressive disclosure) 구조가 권장됩니다.
AGENTS.md도 마찬가지입니다. 오타 하나를 고치기 전에 저장소 전체 구조부터 읽게 하는 지시는 컨텍스트만 소모하고 작업을 느리게 합니다. 이전 모델에는 테스트와 검증을 독려해야 했지만, GPT-6 Astra는 스스로 수행하므로 같은 지시가 불필요한 테스트로 이어질 수 있습니다. 대신 안전이 확인된 작업 흐름에는 명시적인 실행 권한을 부여하고, 시작 전에 ‘어디까지 하면 완료인지’를 요청에 못박아 두는 편이 낫습니다. 새 모델은 판단력이 좋아진 만큼 행동 경계를 엄격하게 받아들여, 계속 진행해도 되는 지점에서 멈춰 검토를 요청하기도 하기 때문입니다.
Tech Insight — 새 모델을 도입하는 순간은 프롬프트를 ‘대청소’할 기회이기도 합니다. 분기마다 스킬과 AGENTS.md를 감사(audit)해 낡은 지시를 걷어내는 것을 루틴으로 삼아 보세요. 에이전트에게 위 기준으로 직접 감사를 시키는 것도 방법입니다.
계정도 API 키도 없이, 내 PC에서 목소리를 만든다
5~15초 샘플이면 끝나는 로컬 음성 스튜디오
VoiceStudio는 계정·API 키·구독 없이, 필요한 모델만 내려받으면 오프라인에서도 돌아가는 오픈소스 데스크톱 앱입니다. 깨끗한 5~15초 샘플만 있으면 별도 학습 없이 목소리를 복제해 원하는 문장을 그 목소리로 읽게 할 수 있고, 나이·억양·음높이·말투를 설명해 아예 새로운 목소리를 만들 수도 있습니다. 단순한 복제를 넘어 워크플로를 통째로 담은 것이 특징입니다. 영상의 말을 텍스트로 옮기고 번역한 뒤 화자별 목소리를 유지해 더빙 영상으로 내보내고, EPUB·PDF를 불러와 등장인물마다 다른 목소리를 배정해 장별로 생성한 .m4b 오디오북까지 만들어 줍니다.
단축키를 누르고 말하면 받아쓴 내용을 현재 앱에 바로 입력하는 기능, 음성과 배경음 분리, 화자 구분, 그리고 AudioSeal 워터마크 삽입·감지까지 지원합니다. 음성 합성 엔진 16개와 인식 엔진 11개를 골라 쓸 수 있고, 로컬 API·OpenAI 호환 음성 API·MCP 서버를 제공해 다른 앱이나 AI 에이전트에서 호출할 수도 있습니다. macOS(애플 실리콘)·Windows·Linux 설치 파일과 Docker를 제공하며, GPU 없이 CPU로도 실행됩니다(RAM 16GB, GPU 사용 시 VRAM 8GB 이상 권장). 앱 라이선스는 AGPL-3.0입니다.
Tech Insight — 주목할 지점은 MCP 서버 제공입니다. 로컬 TTS·STT를 AI 에이전트 파이프라인에 그대로 물릴 수 있다는 뜻이기 때문입니다. 다만 5초로 목소리가 복제되는 시대인 만큼, AudioSeal 워터마크 같은 안전장치는 선택이 아니라 필수로 봐야 합니다.
MIT를 버리고 EUPL로, 28년 개발자의 결심
허용적 라이선스는 정말 우리에게 이득이었나
28년간 소프트웨어를 공개해 온 개발자 Bergie가 기본 라이선스를 MIT에서 EUPL-1.2로 바꿨습니다. 이유는 명확합니다. 허용적(permissive) 라이선스가 사용자와 개발자보다 대기업의 개발비 절감과 부의 축적에 더 기여했다는 판단입니다. EUPL은 유럽연합이 만든 OSI 승인 자유 소프트웨어 라이선스로, 배포 방식과 무관하게 상호적 라이선스 적용을 요구하는 강력한 카피레프트를 통해 이른바 ‘SaaS 허점’을 막습니다. 법적 효력을 갖는 23개 언어 공식 번역을 제공한다는 점도 특징인데, 소프트웨어 상당수가 실리콘밸리 바깥에서 만들어지고 쓰인다는 현실을 반영한 선택입니다.
그는 reticulum-js 등 새로 공개하는 프로젝트에는 EUPL을 적용하되, 외부 기여가 많이 쌓인 기존 프로젝트 NoFlo는 MIT를 유지한다고 밝혔습니다. 물론 논쟁도 있습니다. EUPL의 호환성 조항이 더 약한 카피레프트로 재라이선스할 길을 열어 SaaS 허점을 우회할 수 있다는 FSF의 지적, 그리고 대기업이 코드를 데이터센터에 통과시키는 것만으로 라이선스를 사실상 무시하는 듯한 LLM 시대에 실효성이 얼마나 있겠느냐는 우려가 대표적입니다.
Tech Insight — ‘라이선스 정치’가 다시 뜨거워지고 있습니다. AGPL이냐 EUPL이냐의 선택은 곧 SaaS 사업 모델, 그리고 유럽 시장 진출 전략과 직결됩니다. 오픈소스로 무언가를 공개할 계획이라면, 이제 라이선스는 마지막에 대충 고르는 항목이 아니라 처음부터 설계해야 할 변수입니다.
Four frontier models launched in one week (Sep 1 to 3): Anthropic’s Fable 5.1 and Mythos 5.1, Meta’s Muse Spark 1.3, Google’s Gemini 3.8 Flash, and OpenAI’s GPT-6 Astra.
AI spend per employee at the top 1% of firms fell nearly 10% to $7,205 in August, according to Ramp data covering 70,000 companies.
Average token prices dropped to $0.68 per million, down from a March peak of $1.15, as OpenAI and Anthropic cut prices.
Just 56% of Ramp customers paid for AI in August, up only 0.4% month over month; the US Census Bureau puts overall business AI use at 22%.
In the first three days of September, four of the world’s largest AI labs shipped brand-new frontier models. In the same stretch of the calendar, the amount that top companies actually spent on AI per employee went down, not up. That gap between how fast the industry is shipping and how fast buyers are absorbing what it ships is the most important trend in enterprise AI right now, and almost nobody is putting the two numbers side by side.
The Busiest Week the AI Industry Has Ever Had
Four frontier models in seventy-two hours
The wave started on September 1, when Anthropic released Claude Fable 5.1 and Claude Mythos 5.1, which it called its “most advanced models for coding and knowledge work.” Meta followed on September 2 with Muse Spark 1.3, and Google pushed out Gemini 3.8 Flash in the same burst. Then on September 3, OpenAI shipped GPT-6 Astra, describing it as its most capable and aligned system yet. Four labs, four flagship releases, one week.
CNBC captured the mood in a single phrase: “model fatigue.” The releases now arrive so quickly that IT buyers can barely finish evaluating one model before the next one lands. It is telling that in the same window, more than 1,100 employees at frontier labs separately petitioned Washington to help pace the development of frontier AI. The people building the models are asking for a slower clock at the exact moment the release calendar has never been faster.
Trend Insight — A release cadence measured in days only pays off if adoption keeps pace. When new capability arrives faster than teams can test, budget, and deploy it, each launch competes less with rivals and more with the unspent potential of the model that shipped last month.
The Number That Should Worry Model-Makers
Spend per employee dropped as prices fell
The payments company Ramp tracks AI spending across roughly 70,000 businesses, and its August reading is a warning light. Spend on AI per employee at the top 1% of firms in Ramp’s sample fell nearly 10% to $7,205. Overall, 56% of Ramp customers paid for an AI product in August, a rise of just 0.4% from the month before. A separate US Census Bureau survey, updated on August 23, found only 22% of businesses report using AI at all.
Part of the drop is simply that AI got cheaper. As OpenAI and Anthropic cut prices, the average cost of a token fell to $0.68 per million, down from a 2026 peak of $1.15 per million in March. The problem for model-makers is that the price cuts have not yet been offset by rising volume. Ramp economist Ara Kharazian put it bluntly: competition between OpenAI and Anthropic is “driving spend down at the top 1% of companies that previously the market was expecting to drive much of the growth going forward.” Lab employees have said much of a model’s training cost is recouped in the first weeks after release, so slower uptake threatens the economics of the whole cycle.
Trend Insight — Falling token prices plus flat volume is a revenue-per-seat squeeze. The hundreds of billions committed to AI infrastructure assume usage compounds fast enough to pay it back. A single soft month is not a verdict, but it is the first data set pointing the other way.
Why Buyers Are Reaching for Yesterday’s Model
Older and cheaper is quietly winning
The most revealing detail in the data is what companies are choosing to run. Rather than jumping to each new flagship, many buyers are deliberately staying on older, cheaper models such as OpenAI’s ChatGPT 5.6-Terra and Anthropic’s Sonnet. And despite endless talk of open-weight models storming the frontier, only 6.4% of AI-spending businesses used a model-serving or inference platform in August, a share that is growing but not fast enough to move the overall market.
The pricing itself keeps pulling buyers toward restraint. With Fable 5.1, Anthropic held its headline rates steady but cut cached input reads from $1 to $0.25 per million tokens, making typical workloads about 25% cheaper and heavily agentic ones as much as 45% cheaper. Meanwhile, investors clearly do not see a single winner: coding startup Cognition reached a $48 billion valuation on September 8, a bet that AI coding is far from a winner-take-all market. For a buyer, “good enough and cheap” has rarely looked more rational than “newest and most expensive.”
Trend Insight — When last year’s model does 90% of the job at a fraction of the price, the frontier premium becomes a hard sell. The labs know it, which is why their attention is shifting from raw benchmarks to winning over non-technical users who never compare model cards.
What This Means If You Are Buying AI
Three moves for the next quarter
First, make the cheaper model your default and force the upgrade to earn its place. Benchmark a frontier release against the model you already run on your own tasks before you migrate; the August data suggests most teams that skipped the jump lost very little. Second, measure cost per outcome rather than model version. The metric that matters is dollars per resolved ticket, per shipped feature, or per approved document, not which flagship badge sits in your stack.
Third, treat portability as leverage. The price war between OpenAI and Anthropic is actively working in buyers’ favor, and the customers who can move workloads between providers are the ones capturing the savings. As Kharazian noted, the slump reads as bad news only if you sell tokens: “It depends on who you are in the market. If your company is using AI, it’s great.” For once, the reality check lands on the sellers, not the buyers.
Trend Insight — The winners of this phase are disciplined buyers, not reflexive early adopters. In a market shipping four flagships a week, the durable advantage is a clear-eyed process for deciding when a new model is actually worth switching to.
생계급여 1인 가구 월 최대 82만 1000원에서 87만 6000원으로 (연 약 66만원 증가)
기준 중위소득은 생계·의료·주거·교육급여 등 수십 개 복지의 자격 기준선
의료급여·기초연금·장애인연금·노인일자리도 함께 확대 — 예전 탈락자도 다시 확인
예전에 ‘소득이 조금 많다’는 이유로 복지 문턱에서 돌아선 적 있으신가요. 2027년에는 그 문턱 자체가 내려갑니다. 정부가 기준 중위소득을 역대 최대인 6.7% 올리기로 하면서, 생계급여를 비롯한 수십 개 지원의 자격선이 함께 올라가기 때문입니다. 내 얘기인지 핵심만 짚어보겠습니다.
무엇이 바뀌나 — 2027년 기준 중위소득·생계급여
2027년 예산안의 복지 핵심은 기준 중위소득 6.7% 인상입니다. 기준 중위소득은 정부가 매년 정하는 국민 소득의 중간값으로, 각종 복지의 자격을 가르는 기준선 역할을 합니다.
이 기준선이 오르면 생계급여 지급액도 함께 오릅니다. 생계급여 1인 가구 월 최대 지급액은 82만 1000원에서 87만 6000원으로 늘어납니다.
항목
2027년 기준
기준 중위소득 인상률
6.7% (역대 최대)
생계급여 1인 가구(월 최대)
82만 1000원에서 87만 6000원으로
노인일자리
115만 개에서 118만 개로
보건복지부 2027 예산
148조 7697억원 (+8.2%)
정부 총지출(2027안)
820조 9000억원 (역대 최대)
정책 분석 — 이 숫자 하나가 생계·의료·주거·교육급여는 물론 수십 개 지원의 커트라인을 동시에 움직입니다. 6.7% 인상은 곧 자격 커트라인이 그만큼 위로 올라간다는 뜻입니다. 지난해 ‘소득 초과’로 아깝게 탈락한 경계선 가구일수록, 2027년 재신청의 가치가 큽니다.
나도 대상일까 — 30초 자격 체크
30초 자격 체크
가구 소득인정액이 기준 중위소득의 32%(생계)~50%(교육) 이하다
예전에 소득이 ‘조금’ 많아 수급에서 탈락한 적이 있다 (기준선 상향으로 재도전 가치)
집에 만 65세 이상 어르신이나 중증장애인이 있다 (기초연금·장애인연금 동시 확인)
실직·질병 등 갑작스러운 위기로 생계가 곤란하다 (긴급복지 대상)
생계·의료·주거·교육, 한 번에 신청하세요
기초생활보장은 생계급여만 있는 게 아닙니다. 소득인정액이 기준 중위소득의 32% 이하면 생계급여, 40% 이하 의료급여, 48% 이하 주거급여, 50% 이하 교육급여 대상입니다.
네 급여 모두 같은 기준 중위소득을 기준으로 하므로, 기준선이 오르면 네 가지 문턱이 동시에 낮아집니다. 신청은 주소지 주민센터 한 곳에서 통합으로 하면 되고, 소득·재산을 한 번 심사해 받을 수 있는 급여를 함께 판정합니다.
놓치기 쉬운 포인트 — 부양의무자와 재신청
2027년에는 의료급여의 중증장애인 부양의무자 기준이 폐지돼 수급권자가 약 3만 명 늘어납니다. ‘자녀가 있어서’ 탈락했던 중증장애인 가구라면 다시 확인해볼 필요가 있습니다.
복지는 신청주의입니다. 자격이 돼도 신청하지 않으면 한 푼도 나오지 않습니다. 복지로(bokjiro.go.kr) ‘복지서비스 모의계산’으로 30초 만에 대상 여부를 먼저 확인하세요.
사례 — 1인 수급 가구라면
생계급여를 받는 1인 가구라면 월 지급액이 82만 1000원에서 87만 6000원으로, 매달 5만 5000원씩 늘어납니다. 1년이면 약 66만원입니다. 가구원 수가 많을수록 인상 폭은 더 커집니다.
정책 분석 — 6.7% 인상은 단순한 지급액 증가가 아니라 ‘자격선의 확장’입니다. 오른 물가·생활비만큼 커트라인을 높여, 그동안 제도 밖에 있던 경계선 가구를 안으로 들이는 조치입니다. 챙기지 않으면 그 확장의 혜택을 스스로 포기하는 셈입니다.
함께 늘어나는 복지
기준 중위소득 인상과 함께 2027년에는 취약계층 지원이 전반적으로 넓어집니다. 내 상황에 겹치는 항목이 있는지 확인해 보세요.
제도
2027년 달라지는 점
기초연금
부부감액 축소 등으로 최대 12만 4000원 추가 지원
의료급여
중증장애인 부양의무자 기준 폐지, 수급권자 약 3만 명 증가
장애인연금
장애 정도가 심한 1~3급 전체로 확대, 26만 명 이상 증가
노인일자리
115만 개에서 118만 개로
긴급복지
위기 시 생계비 30만 원 우선 지원(‘우선드림’)
취약계층 먹거리
‘그냥드림’ 150개소에서 300개소로 확대
왜 지금 챙겨야 하나
정책 배경 — 역대 최대 예산, 양극화 대응
2027년 정부 총지출은 820조 9000억원으로 역대 최대(+12.8%)입니다. 이 중 보건복지부 예산이 148조 7697억원으로 8.2% 늘었습니다. 기준 중위소득을 역대 최대폭으로 올린 건, 성장의 온기를 저소득층까지 넓히려는 ‘K자형 양극화 대응’의 핵심 카드입니다.
안 챙기면 잃는 것 — 기회비용
기준선이 올라도 신청하지 않으면 달라지는 건 없습니다. 특히 몇 만원 차이로 탈락했던 가구, 부양의무자 때문에 포기했던 가구가 그대로 두면 연 수십만~수백만원의 지원을 놓칠 수 있습니다.
정책 분석 — 이번 수치는 2027년 예산안 기준으로, 9월 3일 국회에 제출돼 연말 확정, 2027년 1월 시행 예정입니다. 기준 중위소득 인상은 이미 확정된 방향이고 의료급여·기초연금 완화도 이어질 전망이라, 올해 탈락한 가구도 내년 초 다시 문을 두드릴 이유가 충분합니다.
자주 묻는 질문
Q. 기준 중위소득이 오르면 왜 좋나요?
생계·의료·주거·교육급여 등 수십 개 복지의 자격선이 함께 올라갑니다. 지금까지 소득이 조금 많아 탈락했던 가구도 새로 대상이 될 수 있습니다.
Q. 얼마나 오르나요?
2027년 기준 중위소득이 6.7% 인상됩니다. 생계급여 1인 가구 월 최대액은 82만 1000원에서 87만 6000원으로 늘어납니다.
Q. 어디서 확인·신청하나요?
복지로(bokjiro.go.kr) 모의계산으로 대상 여부를 확인하고, 주소지 주민센터에서 신청하면 여러 급여를 한 번에 심사받을 수 있습니다.